welch(x, fs=fs) は短いコードでPSDを推定できます。しかし、256点のセグメントで十分なのか、nfft=8192 にすれば近い周波数を分離できるのか、PSDのピークをどうパワーに換算するのかは別の問題です。
この記事は、 窓関数とPSDの基礎 を踏まえて、パラメータの選定と数値の検算に絞ります。窓の種類の比較ではなく、測定目的から設定を決めるための実践編です。
最初に決めるのはFFT点数ではなく観測時間
全記録のサンプル数を \(N\) 、サンプリング周波数を \(f_s\) 、セグメント長を \(L\) 、重なりを \(O\) とします。
\[ T_{\mathrm{seg}} = \frac{L}{f_s}, \qquad H=L-O, \qquad K=1+\left\lfloor\frac{N-L}{H}\right\rfloor \]ここで \(H\) はセグメントの開始位置の間隔、\(K\) は末尾の不完全なセグメントを使わない場合のセグメント数です。\(N\ge L\) と \(0\le O<L\) を前提とします。
| パラメータ | 主に変えるもの | 増やすとどうなるか |
|---|---|---|
nperseg=L | セグメント観測時間・窓の周波数幅 | 近接ピークを分離しやすくなるが、固定記録長では平均数が減る |
noverlap=O | セグメントの開始間隔 | セグメント数と計算量が増える。平均間の相関にも注意 |
nfft=M | 出力周波数グリッド | \(f_s/M\) の刻みになる。観測時間は増えない |
たとえば \(f_s=1024\) Hz、\(N=32768\) 、50%重なりなら次のようになります。
nperseg | nfft | セグメント時間 | 周波数刻み | セグメント数 |
|---|---|---|---|---|
| 512 | 512 | 0.5 s | 2 Hz | 127 |
| 512 | 8192 | 0.5 s | 0.125 Hz | 127 |
| 4096 | 8192 | 4 s | 0.125 Hz | 15 |
2行目と3行目は同じ周波数刻みですが、同じ分解能ではありません。
nperseg:必要なピーク間隔から逆算する
周期的なHann窓では、主ローブの零点間幅はおおむね \(4f_s/L=4/T_{\mathrm{seg}}\) Hzです。これは近接ピークを考える目安であり、「その幅以上なら必ず分離できる」という保証ではありません。振幅比、ノイズ、リークも効きます。
100 Hzと104 Hzの2成分なら、512点のHann窓の零点間幅は8 Hz、4096点では1 Hzです。まず長いセグメントで両者が分かれるか確認し、その後に平均数を確保できるかを見ます。
- 周波数の近い2ピークを分けたい:
npersegを長くして比較する。 - 広帯域ノイズの水準を安定して知りたい:必要な周波数幅を保ちつつ短くし、平均数を増やす。
- 状態が時間とともに変化する:全記録を一つのPSDに平均してよいかを先に判断する。時間変化には STFT を検討する。
記録時間も重要です。長いセグメントを選んだ結果、数個しか平均できないなら、追加の記録が必要な場合があります。パラメータ変更だけでデータ不足を埋めることはできません。
nfft:ゼロパディングは周波数軸の補間
nfft は nperseg 以上にします。長さ \(L\)
の窓付きデータにゼロを追加してFFTを計算すると、その有限データのスペクトルをより細かい周波数で評価できます。
ピーク位置や形状を見るには便利ですが、窓の主ローブは狭くなりません。512点を8192点FFTにしても、4秒間観測した4096点のセグメントにはなりません。
また、細かくなった周波数ビンは互いに独立な追加観測ではありません。ビン数が増えたことを、統計的な情報量が増えたことと取り違えないようにします。
noverlap:50%を出発点に、平均数を過信しない
Hann窓の50%重なりは、データ利用と計算量を調整する出発点です。 SciPyのWelch API でも、この組み合わせの目安が示されています。
重なりを増やすと \(K\) は増えますが、同じサンプルを共有するためセグメントの推定値は相関します。独立なピリオドグラムの平均なら相対的な標準偏差は概ね \(1/\sqrt K\) に下がりますが、重なるセグメントにその式をそのまま適用すると精度を過大評価し得ます。
75%や90%を試すなら、曲線が滑らかになったかだけで判断せず、計算量と推定結果の安定性を比べます。異なる記録や反復測定で再現するかが、単一グラフの見た目より重要です。
densityとspectrum:単位とENBWで整理する
入力がV、fs がHzなら、scaling='density' は V²/Hz、scaling='spectrum' は V²です。同じ窓・同じ設定で両者を計算すると、次の関係になります。
周期的Hann窓では \(B_{\mathrm{ENBW}}=1.5f_s/L\) Hzです。ここで基準となるビン幅は \(f_s/L\) であり、ゼロパディング後の \(f_s/\mathrm{nfft}\) ではありません。
したがって、spectrum を単純に全ビン足すと、一般には信号の総パワーになりません。特にゼロパディングでビン数を増やした場合に誤ります。総パワーの検算には density と周波数刻みを使うのが明確です。
孤立した正弦波のRMS振幅をピークから読む用途と、広帯域ノイズの総パワーを積分する用途も区別します。Hann窓のビン間のピークにはスキャロッピング損失があり、単に sqrt(Pspectrum.max()) を常に正確なRMS値とすることはできません。
再現コード:近接成分・ノイズ・総パワーを同時に確認
32秒の信号に、DC 2 V、100 Hzの振幅1 V、104 Hzの振幅0.5 V、標準偏差0.2 Vの白色ノイズを加えます。理論的なAC平均パワーは \(1^2/2+0.5^2/2+0.2^2=0.665\) V²です。
窓を get_window('hann', L, fftbins=True) で明示的に作り、SciPyの既定値への依存を避けます。fftbins=True は周期窓です。
get_window API
に周期窓と対称窓の区別があります。
import numpy as np
import matplotlib.pyplot as plt
from scipy.signal import get_window, welch

rng = np.random.default_rng(20261011)
fs = 1024.0
N = 32768
t = np.arange(N) / fs
x = 2.0 + np.sin(2 * np.pi * 100 * t)
x += 0.5 * np.sin(2 * np.pi * 104 * t)
x += rng.normal(0.0, 0.2, N)

fig, axes = plt.subplots(1, 2, figsize=(11, 4), constrained_layout=True)
for L, nfft in [(512, 512), (512, 8192), (4096, 8192)]:
    overlap = L // 2
    w = get_window('hann', L, fftbins=True)
    kw = dict(fs=fs, window=w, nperseg=L, noverlap=overlap,
              nfft=nfft, detrend='constant', return_onesided=True,
              average='mean')
    f, p = welch(x, scaling='density', **kw)
    _, s = welch(x, scaling='spectrum', **kw)
    df = f[1] - f[0]
    enbw = fs * np.sum(w**2) / np.sum(w)**2
    power = np.sum(p) * df
    hop = L - overlap
    starts = range(0, N - L + 1, hop)
    weighted = []
    for start in starts:
        segment = x[start:start + L]
        segment = segment - segment.mean()
        weighted.append(np.sum((segment * w)**2) / np.sum(w**2))
    assert np.allclose(s, p * enbw)
    assert np.isclose(power, np.mean(weighted), rtol=1e-12)
    K = 1 + (N - L) // hop
    print(f'L={L:4d} nfft={nfft:4d} K={K:3d} df={df:.3f} '
          f'ENBW={enbw:.3f} power={power:.6f}')
    label = f'L={L}, nfft={nfft}'
    axes[0].plot(f, p, label=label)
    axes[1].semilogy(f, p, label=label)
for ax in axes:
    ax.set_xlabel('Frequency [Hz]')
    ax.set_ylabel('PSD [V²/Hz]')
    ax.grid(alpha=0.25)
    ax.legend(fontsize=8)
axes[0].set_xlim(94, 110)
axes[0].set_title('Close tones: segment length vs zero padding')
axes[1].set_xlim(150, 300)
axes[1].set_ylim(1e-5, 1e-3)
axes[1].set_title('Noise floor: fewer averages at larger L')
plt.show()
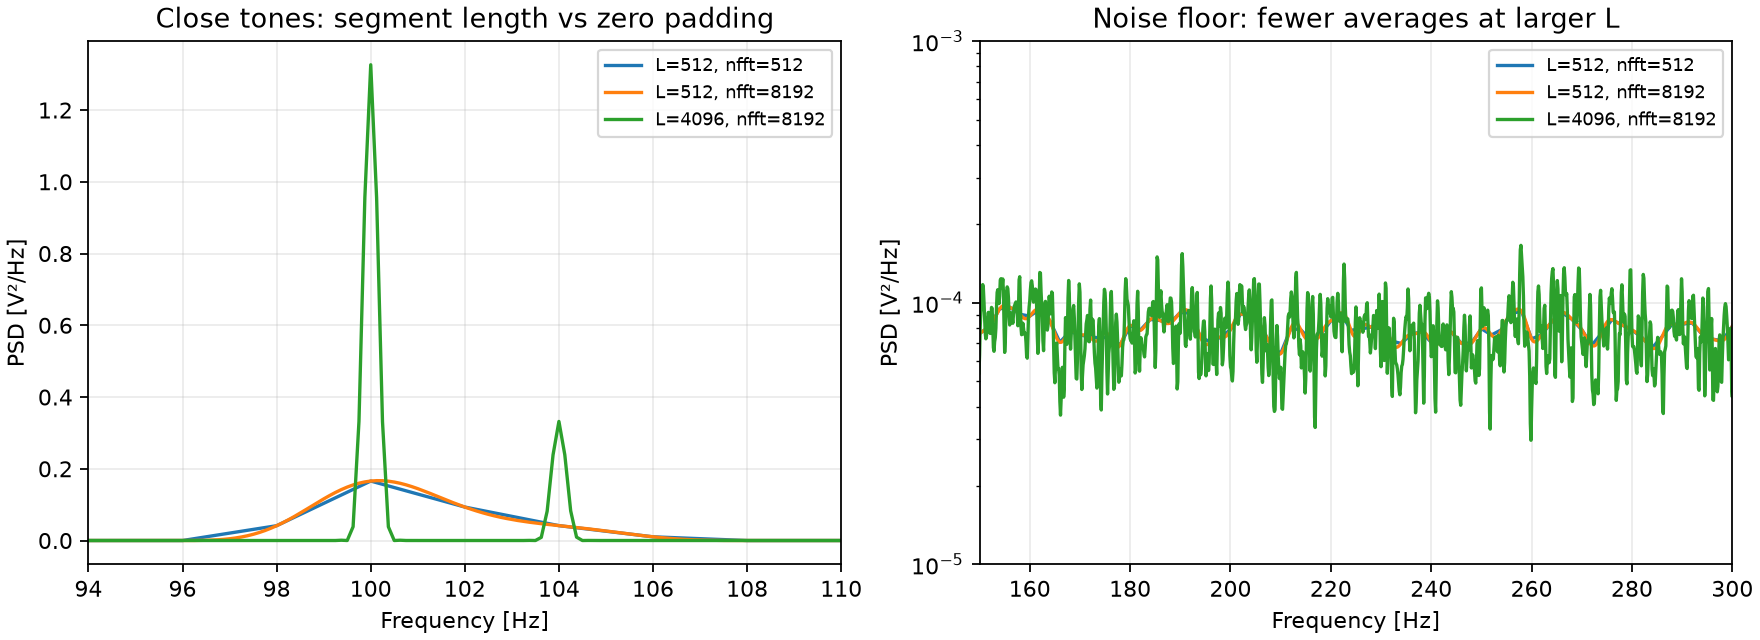
実行結果(NumPy 2.5.4、SciPy 1.18.1):
L= 512 nfft= 512 K=127 df=2.000 ENBW=3.000 power=0.744158
L= 512 nfft=8192 K=127 df=0.125 ENBW=3.000 power=0.744158
L=4096 nfft=8192 K= 15 df=0.125 ENBW=0.375 power=0.661559
左図では、512点のゼロパディングで曲線のサンプルは細かくなりますが、2つのピークの広がりは残ります。4096点では窓の周波数幅が狭くなり、両成分が分かれます。右図の4096点の推定は平均数が少ないため揺らぎが大きくなっています。この図は固定シードの1記録の比較であり、信頼区間の推定ではありません。
PSD積分の検算:全記録の分散と完全一致しない理由
このコードの np.sum(p) * df は、DCとナイキストを含む全ビンを加えます。実数入力の片側PSDでは、内部ビンに負周波数側のパワーが折り込まれています。さらに2倍してはいけません。
average='mean' では、この総和は次の量と数値誤差の範囲で一致します。
\(\widetilde{x}_i\)
は各セグメントで平均除去した信号です。コード内の2つ目の assert はこのParsevalの関係を検証しています。
一方、np.var(x) は全記録を等しい重みで扱うため、セグメントごとの平均除去・窓の重み・記録端の利用回数が異なります。十分なセグメント長と適切な平均化では近似できますが、決まった位相関係の成分などでは差が残る場合があります。完全一致を必須条件にしないでください。
この例では、512点の総パワー0.744158 V²は全記録の分散0.661787 V²より大きくなっています。2つの近接した固定位相の正弦波は、Hann窓の二乗で重み付けすると交差項が消えず、このホップ幅では同じ相対位相の区間を繰り返し使うためです。ノイズを除いた検算でも512点では0.708333 V²、4096点では0.625000 V²となり、全記録の分散は0.625000 V²です。
つまり、Parsevalの assert が通ることは窓付きセグメントの正規化が正しいことの確認であって、どのセグメント長でも元の信号の総パワーを同じ精度で推定できる保証ではありません。ゼロパディングではこの差も変わりません。
台形則は端点を半分の重みにするため、この離散FFTのパワー総和とは異なります。DCが大きいと差が目立ちます。全ビンのParseval検算では sum * df、連続曲線としての帯域積分では境界ビンの扱いを含めた積分法、という目的の区別が必要です。
detrend:DCを含めたいのか、変動を知りたいのか
detrend='constant' は各セグメントの平均を引きます。DC以外にも、セグメントより長い周期の低周波成分に影響し得ます。低周波を見るときには、単なる無害な前処理ではありません。
DCを含む平均二乗を調べるなら、同じ信号に対して次を追加します。
print(f'variance={np.var(x):.6f} mean_square={np.mean(x**2):.6f}')
w = get_window('hann', 4096, fftbins=True)
f, p = welch(x, fs=fs, window=w, nperseg=4096, noverlap=2048,
             nfft=8192, detrend=False, scaling='density', average='mean')
print(f'no_detrend_power={np.sum(p) * (f[1] - f[0]):.6f}')
実行結果(NumPy 2.5.4、SciPy 1.18.1):
variance=0.661787 mean_square=4.656620
no_detrend_power=4.653860
平均二乗には約 \(2^2=4\)
V²のDCパワーが加わります。detrend=False の総和と分散を比較して「PSDが4 V²ずれている」と判断すると、DCの扱いを取り違えています。
実データでの確認手順
fsの単位とサンプル間隔を確認する。不等間隔の記録を通常のWelch法にそのまま入れない。- 分けたいピークの間隔と信号の定常性から
npersegを決める。 - Hann窓・50%重なりを起点に、平均数 \(K\) を計算する。
nfft=npersegとゼロパディングの結果を比較し、表示刻みと分解能を区別する。densityの総和でパワーを検算し、DC・平均除去・入力単位を確認する。- パラメータを一段階変えた結果と別記録を比較し、結論が維持されるか確かめる。
PSDが表すのは時間平均した周波数ごとのパワーです。単発の過渡現象や時間変化を平均で薄めてよいかを含めて、解析の目的に設定を合わせます。
よくある質問
Welch法でnfftを増やすと周波数分解能は上がりますか?
出力周波数の刻みは細かくなりますが、同じセグメント長と窓のままでは近接成分の分離能力は改善しません。nperseg と窓の周波数幅を確認します。
PSDを積分すると分散になりますか?
density の全ビンを周波数刻みで掛けて総和すると、窓で重み付けしたセグメントの平均二乗になります。十分なセグメント長と適切な平均化では分散を近似できますが、固定位相の近接成分では差が残る場合があります。全記録の分散との完全一致は一般には成立しません。
Welch法のnoverlapはどれくらいがよいですか?
Hann窓なら50%を出発点にできます。重なりを増やすとセグメント数は増えますが相関も増えるため、独立な平均数が同じ割合で増えるわけではありません。
関連記事
- FFTの振幅補正とゼロパディング :PSDと区別したい片側振幅・窓補正・ゼロパディングの正規化。
- 窓関数の選び方とPSD推定 :窓の周波数特性・リーク・スキャロッピングの基礎。
- DTFT・DFT・FFTの違い :有限データの周波数評価とFFTの位置付け。
- サンプリング定理とエイリアシング :PSD推定前に確認したいサンプリング条件。
- 時間周波数解析の選び方 :時間平均のPSDでは不十分な場合の手法選択。