AIがコードを書く速度が上がると、それを確認する人間のレビューが追いつかなくなります。MetaのRADARは、変更の発生源・リスク・検証結果に応じて、自動化できる変更を選別する仕組みです。
この記事は、Chris Adamsほかによる “Automating Low-Risk Code Review at Meta: RADAR, Risk Calibration, and Review Efficiency” の日本語訳です。
原著・翻訳について
- 原著: arXiv:2605.30208v2 (2026年6月12日改訂)、 原文HTML 、 PDF 。
- 著者:Chris Adams, Arjun Singh Banga, Parveen Bansal, Souvik Bhattacharya, Payal Bhuptani, Rujin Cao, Pedro Canahuati, Nate Cook, Brian Ellis, Prabhakar Goyal, Gurinder Grewal, Tianyu He, Matt Labunka, Alex Manners, David Molnar, Ging Cee Ng, Vishal Parekh, Jiefu Pei, Frederic Sagnes, James Saindon, Will Shackleton, Sid Sidhu, Gursharan Singh, Karthik Chengayan Sridhar, Matt Steiner, Pratibha Udmalpet, Sean Xia, Stacey Yan, Audris Mockus, Peter Rigby, Nachiappan Nagappan。
- ライセンス:原著 © 2026 原著者。原著は CC BY-SA 4.0 で公開されています。本記事の翻訳・訳注も同じライセンスで提供します。図1〜4は原著から変更せず転載し、図の説明と表を日本語に翻訳しています。参考文献の書誌情報は原語のまま掲載します。この利用条件は本記事の翻訳・訳注・転載図表に適用され、サイト全体や広告などの別コンテンツには及びません。
- 翻訳範囲:要旨および本文第1〜7節、図の説明、表1〜6。節番号は原著に合わせ、読みやすさのため段落・箇条書きを整えています。著者による公式訳ではありません。本文中の「私たち」は原著者を指し、翻訳者の補足は「訳注」として区別します。
用語は、diff を「コード変更の単位」、landing を「変更をコードベースへ取り込むこと」、revert を「取り込んだ変更の差し戻し」、PI(Production Incident) を「本番環境のインシデント」として読み進めてください。RADARの承認・取り込みは、必ずしも本番環境へのデプロイ完了と同じ意味ではありません。
訳注:数値の読み方 — 原著には「クローズまでの時間の中央値を330%超短縮」とあります。通常の短縮率では100%を超える短縮は成立しないため、本訳では原文の表現を残し、確定した改善倍率として扱いません。また、RADARは低リスクの変更を選別して処理するため、非RADAR変更とのインシデント率の差を、そのまま自動レビューの因果的な安全性改善と読むことはできません。
要旨
背景:AIによるコーディング支援ツールは、ソフトウェアの作り方を変化させている。Metaでは、人間が取り込んだdiffあたりの実質的なコード行数が前年比105.9%増加し、開発者あたりのdiff数は51%増加した。この増加の80%超は、エージェント型AIによるものである。一方、適時にレビューを受けるdiffの割合は低下しており、コードの供給量とレビュアーの処理能力の隔たりが広がっている。
目的:実現可能性、調整、効果の順に、3つの問いを検討する。(1)リスク別に処理を分ける自動化は、多様な組織で大規模に運用できるか。(2)リスクのしきい値を調整すると、自動化できる割合と安全性のトレードオフはどう変化するか。(3)自動レビューは、AIが生成した変更の処理全体にかかる時間をどの程度短縮するか。
方法:私たちはRADAR(Risk Aware Diff Auto Review)を導入した。これは、各diffを作成者と生成元の種類で分類し、適格性の判定、静的なヒューリスティクス、機械学習によるDiff Risk Score、LLMによる自動コードレビュー、決定論的な検証を経て、条件を満たす変更を取り込む多段階のファネルである。RADARがレビューした53万5,000件超のdiffのテレメトリ、ポリシー変更前後の観察的比較、効率面の結果に対する差の差分析を用いて評価する。
結果:RADARは53万5,000件超のdiffをレビューし、33万1,000件超を取り込んだ。Diff Risk Scoreのしきい値を第25パーセンタイルから第50パーセンタイルへ緩和したところ、承認率は60.31%となった。RADARがレビューしたdiffの差し戻し率は非RADAR変更の3分の1、本番インシデント率は50分の1だった。人間がレビューしたdiffと比べて、クローズまでの時間の中央値は330%超短縮され、レビューに費やす実経過時間の中央値は35%短縮された〔330%の表現については冒頭の訳注および第4.3節を参照〕。
結論:リスクを考慮した多層的な自動化は、段階的な導入において本番環境の安全性を損なうことなく、AIによるコード増加が生むレビューのボトルネックを大幅に緩和できる。
キーワード:AI、開発者の生産性。
1. はじめに
コードレビューは、ソフトウェア開発で正確性と保守性を高めるために行われる。これまでMetaでは、レビュアーの処理能力とツールの改善によって、レビューの待ち時間を許容範囲に保てていた。しかし、コードを作成するプロセスが変わりつつあり、大規模なレビューを支えてきた前提が揺らいでいる。
過去1年間で、人間が取り込んだdiffあたりの実質的なコード行数は前年比105.9%増加し、開発者1人あたりの月間diff数は51%増加した。この増加の80%超はエージェント型AIの支援による。一方、24時間以内にレビューされるdiffの割合は低下している。これらの傾向は、コードの作成速度が人間のレビュー能力より速く伸びていることを示唆する。
大規模なグループの一部では、数千件のdiffがレビュー待ちになっていた。この状況では、大半のdiffを人間が読むことに依存したワークフローを拡大するのは難しい。厳密さを保ちながら、人間の判断と説明責任が最も役立つ変更へ、限られた注意を振り向ける仕組みが必要になる。
この問題に対処するため、私たちはRADARを導入した。RADARは、複雑さが低〜中程度のdiffの一部についてレビューと取り込みを自動化し、リスクの高いdiffを人間のレビューへ回す、一貫した多段階の仕組みである。適格性チェック、静的なヒューリスティクス、Diff Risk Score、LLMによる自動コードレビュー、決定論的な検証を組み合わせる。
RADARは、コードレビュー全般の置き換えを目指すのではなく、保守的な安全基準を満たすdiffを自動化の対象とし、段階的な導入と調整を支える運用上の制御を備える。
本論文では、RADARの導入による本番運用での結果を報告する。評価は、実現可能性から調整、開発者への効果へと進む3つの研究課題に沿って構成する。
- RQ1(実現可能性):リスク別の自動化は、本番規模で動作し、多様な組織においてレビュー件数の相当部分を処理できるか。
- RQ2(調整):自動化の適格性を決めるリスクしきい値を変えると、自動化できる割合と安全性のトレードオフはどう変わるか。
- RQ3(効果):自動レビューは、AIが生成したコード変更のレビュー全体にかかる時間をどの程度短縮するか。
結果から、RADARは実用上意味のある規模で動作し、大きな効率向上と関連していることが示された。これまでに53万5,000件超をレビューし、33万1,000件超を取り込み、1日あたり2万5,000件超に達している。現在のRADAR承認率は60.31%で、差し戻し率は非RADAR変更の3分の1、PI率は50分の1である。人間がレビューしたdiffと比べ、クローズまでの時間の中央値は330%超、レビューの実経過時間の中央値は35%短縮されている〔訳注:330%は原文表記〕。
本論文の貢献は3つある。第一に、自動生成されたdiffと人間が作成したdiffで異なるパイプラインを持つ、リスクを考慮したコードレビュー・取り込み自動化の本番ワークフローを説明する。第二に、第2.7節で生成元ごとに異なる適格性モデルを示す。これは、決定論的なcodemod、AI生成codemod、リスク履歴と処理量制御を持つRACERランブック、作成者・範囲の制約を持つ人間のdiffを区別する。第三に、処理量、調整、効率面の結果を通じ、大規模導入の初期的な実証的特徴を明らかにする。
これらの知見は、diff数の急増とAIによるコード作成の進展に合わせて、組織がレビューのワークフローをどう適応させるかに示唆を与える。以降、第2節でMetaのレビュー、RADARの処理、適格性モデルを説明する。第3節で研究設計と指標を示し、第4節で結果を報告する。第6節で妥当性への脅威を論じ、最後に今後のレビュー自動化への示唆を述べる。
訳注:原著第1節の第一の貢献の説明には「RACER」と記されていますが、論文全体の対象はRADARです。RACERは次節で説明するコード変更生成ツールです。
2. 背景・動機・RADARの処理
2.1. Metaにおけるソフトウェア開発
Metaは、サーバー側のサービスと、専用ハードウェア機器を含む利用者向け製品の両方のソフトウェアを開発している。この開発形態は、頻繁なソフトウェア更新と、バージョン・構成の強力な管理を支える。Metaでは、このデプロイ戦略のもとで、新しいコードを頻繁に本番環境へ送り出すことが日常化している。通常、変更はデプロイ前にピアレビュー、自動テスト、カナリアリリースや段階的デプロイを受ける。デプロイ後は、エンジニアがログやテレメトリを監視して問題を検出し、必要に応じて迅速にロールバックする。
コードレビューはMetaの開発の標準的な一部であり、複数の役割を果たす(Shan et al., 2022)。第一に、同僚に確認されることを通じて、作成者が高いコーディング基準を保つよう促す。第二に、レビュアーは不具合を見つけ、可読性を改善し、別の設計を提案できる。これらの利点は大きな組織で重要であり、コードベースの変化やエンジニアのプロジェクト異動に伴って、さらに重要になる。
Metaは、コードレビューと継続的インテグレーションを支えるために Phabricator を使う。開発者はMetaでdiffと呼ばれるコード変更を提出し、変更内容とテスト計画を説明したうえで、1人以上のレビュアー、またはレビュアーグループにレビューを依頼する。レビュアーはインラインコメントや操作によってフィードバックを返す。作成者は、diffが承認されてコードベースに取り込まれる、すなわちlandingされるか、放棄されるまで修正を重ねる。
Phabricatorとバージョン管理システムは、レビューのワークフローを研究するための運用データを提供する。Phabricatorはdiffのメタデータ、作成者・レビュアーの操作、主要なライフサイクルイベントの時刻、各diffの現在の状態を記録する。1つのdiffは、最初の変更とレビューを受けた修正を表す、1つ以上のパッチからなる。本論文は、変更量が急増するMetaのレビューと、説明責任を維持しながらレビューを拡大するために、自動化と保守的なポリシー・検証を組み合わせたワークフロー支援を対象とする。
2.2. RACER
RACER(Risk-Aware Code Editing and Refactoring)は、Metaの生成AIを用いた大規模なコード変更自動化ツールである。開発者は、不要コードの削除、循環的複雑度の低減、フレームワーク移行、lint修正、テスト生成など、明確に定義された作業をAIエージェントへ委ねられる。エージェントは、人間のレビューを受けるdiffを生成する。
RACERはランブックを通じて動作する。ランブックは、特定の種類のコード変更に対する指示、制約、文脈を組み込んだ、事前設定済みのプロンプトである。作業が割り当てられると、RACERはサンドボックス環境でコード変更を生成し、検証を実行してdiffを提出する。開発者はdiffをレビューし、インラインコメントでフィードバックできる。RACERはそれに応じて修正し、ビルド・テスト・静的解析のエラーに対して再試行する。研究時点では、RACERは週に約3,000件のdiffを取り込んでおり、変更の59%は人間による修正なしに取り込まれていた。
RACER Maintainerによる自律的なコードベース保守にも対応する。これは、コード品質ダッシュボードからの問題発見、タスク作成、diff生成、レビュアー割り当て、diffキュー管理まで、大量のコード変更のライフサイクル全体を扱う。循環的複雑度の低減、品質上の指摘への対応、壊れたテストの修正、フレームワーク移行など、多数の変更を伴う用途に使われる。
RACERがRADARに関係するのは、その生成diffがRADARへ入るbot作成diffの主要な供給源の1つだからである。RACERランブックがRADARに登録され、すべての安全チェックに合格すれば、ACEポリシー(第2.8節)を通じて、人間のレビューなしでRADARによるレビュー・取り込みが可能になる。
2.3. Diff Risk Score
Diff Risk Score(DRS)は、diffが悪い結果、主に本番インシデントを引き起こす可能性を予測する機械学習モデルである。すべてのdiffに連続的なリスクスコアを付与し、一定割合のdiffを検出対象としたときに、高い再現率を得るよう最適化されている。たとえば、diffの10%にフラグを立てることで、PIを引き起こす変更の60%を捉える、といった動作である。
スコアはパーセンタイル(PX)で表す。PXというしきい値では、最もリスクが低い側のX%のdiffだけが条件を満たす。低いしきい値ほど保守的で、P5では最も安全な5%だけが、P50では最も安全な50%が通過する。
DRSは当初、OrgAがコードフリーズ中でも低リスクのdiffを取り込めるようにするためのシグナルとして開発された。その後、承認から出荷までのワークフロー、モバイルリリースにおけるcherry-pickのリスク評価、リファクタリングの優先順位付け、高リスクdiffのレビュアー推薦など、Metaの約20の機能を支えるリスク基盤へ発展した。
RADARでは、DRSがパイプラインの複数段階で通過条件として機能する。AI・botのdiffでは、許可リストにあるRACERランブックにP50、それ以外の生成元にはより厳しいP20を使い、RADARによる取り込みの適格性を判定する(第2.8節)。人間のdiffでは、既定値はP5であり、最も低リスクな5%のみが対象となる。RADAR Approvalは、事後レビューを完全に免除するために追加の制約を課す(第2.9節)。各組織は、許容するリスクに合わせてしきい値を設定できる。
2.4. 自動コードレビュー
Automated Code Review(ACR)は、diff内の実際のコード変更を読み、解釈するLLMベースのレビューエージェントである。メタデータや静的なヒューリスティクスを超えて、変更の意味を理解する。Metaのレビューのワークフローに統合され、作成者・レビュアーへの全体的なコメントやインラインコメントの提供と、RADARパイプラインでの自動承認・拒否という2つの役割を持つ。
ACRは、diff内の各変更を、事前定義された安全シグナルとリスクシグナルに照らして分類する。安全シグナルには、動作を変えないリファクタリング、不要コードの削除、防御的プログラミングの追加、ログ追加、純粋な整形、文書・コメント更新、importの整理、テスト追加、静的リソースの更新が含まれる。
リスクシグナルには、計算上のレビュー負荷の高さ(複雑度スコア4以上)、大きな構造変更、発見されたバグや論理エラー、性能上のリスク、秘密情報の露出・SQLインジェクション・認証回避などの脆弱性が含まれる。
自動承認には、信頼度スコアが10点満点で8以上であり、すべての変更が安全なカテゴリに分類されることを要求する。リスクシグナルが1つでも見つかれば、自動承認の対象から外れる。この保守的な基準により、安全性への確信が高い変更だけを先へ進める。
ACRは、静的なヒューリスティクスでは提供できない意味理解の層を加える。静的チェックはメタデータ、ファイルパス、しきい値を扱うが、変更が実際に何をするかは判断できない。ACRによって、大規模だが単純なリファクタリングや機械的な不要コード削除など、静的チェックでは危険とされかねない安全な変更を承認できる。同時に、論理エラーや意図しない動作変更など、パターンマッチでは見つけにくい微妙なリスクも捉えられる。
ACRは、その後継であるDCRとともにRADAR Review Agentを構成する。このAIレビューエンジンは、bot向けのACEパイプライン(第2.8節)と、人間向けのRADAR Verification(第2.9節)で使われる。
2.5. 動機:大規模なレビュー
コードレビューは、正確性、信頼性、共通理解を高める重要な開発活動である。Metaでは、大きなモノレポ全体で変更の整合性を取るための主要な調整手段でもある。しかし、コード作成の性質が変わった。過去1年間で、人間が取り込んだdiffあたりの実質的なコード行数は前年比105.9%増、開発者あたりの月間diff数は51%増となり、その増加の80%超はエージェント型AIの支援に起因する。一方、24時間以内にレビューされるdiffの割合は低下している。コード作成は加速したが、レビューは人間の注意と実時間に制約されたままである。
図1は、研究の動機となるdiffの規模・件数・レビューの適時性の前年比の傾向を示す。
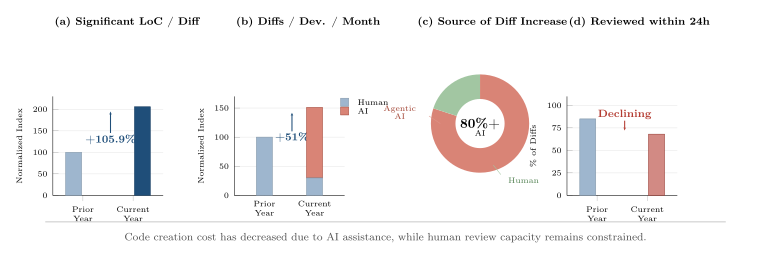
図1(原著から転載):Metaのコードレビューに対する規模拡大の圧力。過去1年間で、人間が取り込んだdiffあたりの実質的なコード行数は105.9%増加し、開発者あたりの月間diff数は51%増加した。その増加の80%超はエージェント型AIの支援による。同じ期間に、24時間以内にレビューされるdiffの割合は低下した。レビュー能力がコード作成に追いついていないことを示す。
この圧力は、diff量が多い製品領域で顕著である。私たちの目標は、厳密さを保ちながら、人間の判断が必要な変更や、リスクを生じやすいdiffに注意を向けることにある。そのため、日常的な低リスクdiffは人間の関与を最小限にして進め、高リスクdiffは責任の所在を明確にして適切なレビュアーへ回す。
2.6. RADARの概要
RADARは、安全性を維持しながらレビュー能力を拡張する私たちの方法である。単独のモデルではなく、処理全体を覆うファネルとして設計されている。静的なヒューリスティクス、Diff Risk Score、LLMレビューエージェントを組み合わせ、保守的なポリシー上のゲートと運用制御でリスクを管理する。
段階的な展開を支える設計でもある。作成者の種類と適格性によって自動化を制限し、自動生成元には登録要件を課す。また、安全上のインシデントを起こした用途の自動化を停止する制御を含む。これにより、利用者向けのレビューツールを変えることなく、対象範囲を徐々に広げ、結果を監視し、しきい値を調整できる。
2.7. diffの適格性
RADARにおける重要な設計判断は、diffをどう分類し、自動レビュー・取り込みの対象とするかである。適格性は単独のチェックではなく、作成者の種類、特定の生成元、組織の状況に依存する多層的な評価である。適格性の判定自体がリスク管理戦略を表し、自動化の範囲を説明するため、ここではパイプラインの仕組みとは独立した貢献として説明する。
図2は、作成者の種類と生成元に基づき、diffを適切なレビュー経路へ振り分ける分類木である。
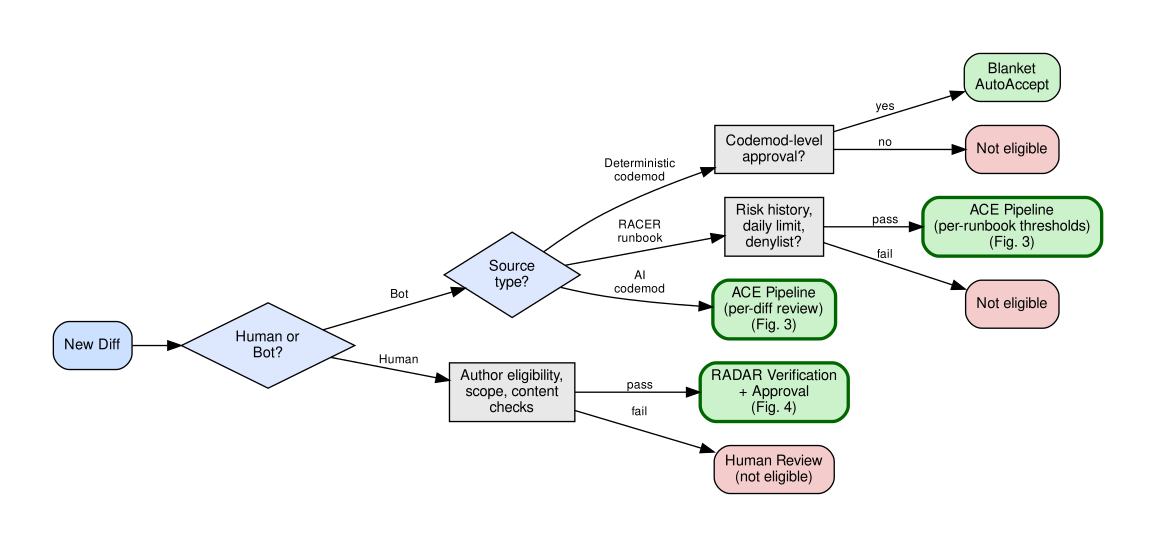
図2(原著から転載):RADARのdiff適格性分類。まず、人間またはbotという作成者の種類で分類し、botは生成元でさらに分類する。決定論的なcodemodは包括的自動承認によってdiffごとのAIレビューを省略できる。AI生成codemodにはdiffごとのACE評価が必要である。RACERランブックは、リスク履歴、1日の上限、拒否リストのチェックを通過してから、ランブック固有のDRSしきい値でACEへ入る。人間のdiffは、作成者、範囲、内容の制約を満たしたうえでVerificationとApprovalへ進む。
2.7.1. 作成者の分類
最初に、diffを人間作成とbot作成に分類する。bot作成diffは、適格性の経路を決める生成元でさらに分類する。人間とbotでは、リスクの特性と処理量が異なるため、この分類が重要となる。
人間作成diffはRADAR VerificationとApprovalへ入り、作成者の属性とdiffのメタデータで適格性を判定する。bot作成diffはACEへ入り、生成元、その実績、生成元ごとの設定によって適格性を判定する。
2.7.2. 生成元ごとのbot diffの適格性
botのdiffをすべて同じようには扱わない。RADARは、自動生成元を3つに分け、それぞれに異なる適格性モデルを設ける。
決定論的なcodemod(Blanket AutoAccept:包括的自動承認):CodemodServiceは、API移行、importの再編成、機械的なリファクタリングなど、決定論的なコード変換を支える。変換が完全に定義され、LLMによる生成を伴わない場合、包括的自動承認のポリシーで承認できる。変換自体をcodemod単位で精査済みなので、diffごとのAIレビューは行わない。最も制約の少ない経路だが、そのcodemodが包括的な自動承認に向けてレビュー・承認されている必要がある。
AI生成codemod(Conditional AutoAccept:条件付き自動承認):CodemodServiceの設定がLLM生成を使う場合、コードの文脈やモデルの出力によって各diffが変わるため、包括的な承認はできない。各diffがDRSとACRを含むACEパイプラインを個別に通過する必要がある。これにより、AI生成の変更に本質的に伴うばらつきを、diffごとに精査する。
RACERランブック:RACER生成diffには、最も細かな適格性モデルを適用する。各ランブックを、次の4条件で独立に評価する。
- リスク履歴のヒューリスティクス:過去60日間にPIがゼロで、差し戻し率と人間による拒否率が低く、統計的な信頼性を得るために最低限必要な取り込み件数があること。
- ランブックごとの1日あたり上限:単一のランブックがコミットキューを埋めないよう、RADAR取り込み件数を制限する。既定値は保守的だが、安全性が実証された大量処理用途では、1日最大2,000件まで引き上げられる。
- ランブックごとのDRSしきい値:安全実績が高い許可リスト上のランブックにはP50、それ以外にはより厳しい既定のP20を適用する。
- 拒否リスト:インシデントを起こした、または機微な領域を扱う特定のランブックは、RADAR取り込みから恒久的に除外する。さらに、名前に「test」など特定の語を含むランブックも、人間の監督なしでテスト基盤を変更することを避けるため除外する。
この細かさはRADARの適格性モデルの特徴である。2つのランブックが同じコード変換を行っていても、一方に差し戻し履歴があれば、その一方だけが阻止される場合がある。
2.7.3. 人間のdiffの適格性
人間が作成したdiffは、作成者、範囲、内容の制約を満たすと、RADAR Verificationによる自動レビューの対象となる。
- 作成者の適格性:役割・経験、運用上の責任に関する社内基準を満たすこと。文脈への理解と説明責任が確立したエンジニアのdiffに、自動レビューを適用するためである。
- 範囲の除外:オープンソースコード、SOXの対象コード、追加レビューが必要なコードに触れるdiffは除外する。人間の判断を必要とする制約がある領域を保護する。
- diffの状態制約:作業中、コメント募集、過去に拒否されたdiffではないこと。公開された最新バージョンであり、CIのシグナルが許可された状態にあること。
- 内容のチェック:禁止されたコード表現を含まず、特定の設定やパスに対する接頭辞・接尾辞の拒否リストに一致するファイルを変更しないこと。
2.7.4. 組織ごとの設定
適格性のしきい値は全社で固定されていない。各組織は、OrgRADARPolicyConfigを通じて、DRSしきい値、事後レビューの有効化、許可する生成元を設定し、許容するリスクを調整できる。たとえばOrgAではbotのDRSしきい値を緩和し、実質的にbotのDRSゲートを省略してACRに直接依存する。一方、他の組織はOrgBチームが管理する、より厳しい既定値を維持する。
この設定可能性により、同じ会社の中でもリスク環境が異なる組織に対応できる。表1に、生成元ごとの適格性条件をまとめる。
表1:生成元ごとのRADAR diff適格性条件。 各生成元に、そのリスク特性と運用上の特徴を反映した条件を設ける。
| 条件 | 決定論的codemod | AI codemod | RACERランブック | 人間の作成者 |
|---|---|---|---|---|
| パイプライン | 包括的自動承認 | ACE | ACE | Verification+Approval |
| diffごとのAIレビュー | なし | あり(ACR) | あり(ACR) | あり(ACR) |
| DRSゲート | なし | あり | あり | あり(組織別設定可能) |
| リスク履歴の要件 | なし(codemod単位のレビュー) | なし | あり(過去60日) | なし |
| 1日の件数上限 | なし | なし | あり(ランブック別) | なし |
| 作成者・生成元の審査 | codemodの承認 | codemod設定のレビュー | ランブックの登録審査 | 適格な役割・オンコール・在籍期間 |
| 対象範囲の除外 | 標準 | 標準 | 標準+拒否リスト | 標準+ファイル拒否リスト |
2.8. AI・botのdiff向けRADARパイプライン
第2.7節の適格性チェックを通過したbotのdiffには、ACE(AI Commit Eligibility)というポリシーを使う。厳密な安全基準を満たす自動生成元の変更を、人間のレビューなしに取り込むことが目的である。
図3のように、botの種類によって異なる経路を通る。包括的自動承認を持つ決定論的codemodはACE自体を迂回する。AI生成codemodと適格なRACERランブックは、生成元ごとのDRSしきい値でACEへ入る。ACEに入ったdiffは、静的なヒューリスティクス、DRSのしきい値、自動コードレビューという3層すべてを通過する必要がある。
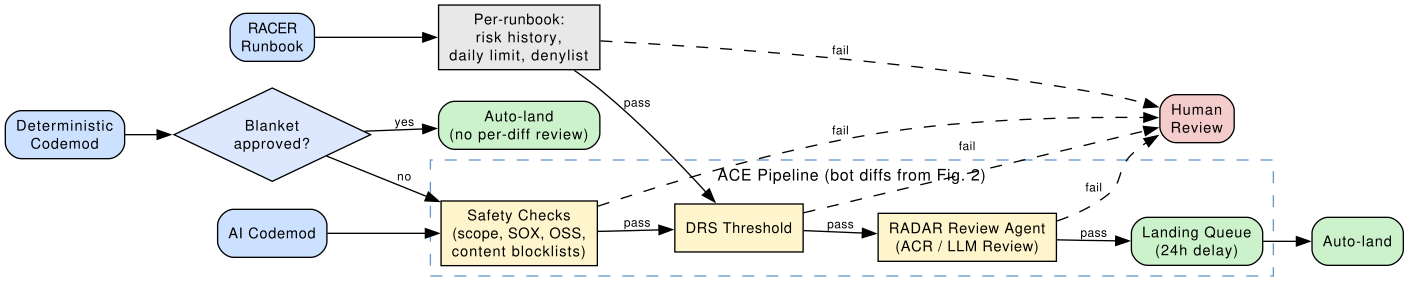
図3(原著から転載):AI・bot diff向けのRADARパイプライン。決定論的codemodの包括的自動承認はACE全体を迂回し、AI生成codemodは直接ACEに入る。RACERランブックは、履歴・日次上限・拒否リストを確認してから、ランブックごとのDRSしきい値でACEに入る。ACEでは、安全チェック、DRS、RADAR Review Agentの3層を通る。承認されたdiffは設定可能な待機時間の後に取り込まれ、いずれかの段階で失敗すれば人間のレビューへ回る。
第一層は、厳格な制約に違反するdiffを除外する静的なヒューリスティクスである。オープンソースではないこと、追加レビューが不要であること、SOX対象コードに触れないこと、登録済みのRACERランブックまたは審査済みのCodemodService設定からの変更であることを要求する。安全な取り込み、低い差し戻し率、異論の少ない変更という実績を持つ生成元だけが登録対象となる。
第二層では、組織の許容リスクに応じたしきい値とDRSを比較する。OrgAと協力組織では、安全実績が確立した許可リスト上のランブックにP50を割り当て、最も安全な50%を通過させる。許可リストにないランブックやその他のAI botには、より厳しいP20を適用する。他の組織の既定しきい値はOrgBチームが管理する。
第三層はRADAR Review Agentである。LLMが実際の変更を読み、安全・リスクシグナルに分類する。人間の判断が必要な業務ロジックが更新されていないことを確認し、不要コード削除、リファクタリング、エラー処理改善、ログ追加、テスト更新など、安全な非機能的パターンを検出する。機能変更については、正しく、かつ人間のレビューなしで進められるほど低リスクかを評価する。リスクシグナルが見つかれば拒否し、人間のレビューへ回す。
AI・botのdiffは大量に生成され得るため、ACEにはキューの過負荷を防ぐ運用上の制約もある。自動取り込みが可能な時間帯や、ランブックごとの日次上限を制限し、たとえばRACERランブックの生成件数を1日10〜2,000件に抑える。承認されたbot diffは設定可能な待機時間の後に取り込まれ、その間も人間のレビュアーは拒否できる。ファネルの監視、阻害要因の発見、しきい値調整のためのフィードバックループも設ける。
2.9. 人間が作成したdiff向けRADARパイプライン
人間のdiffには、RADAR Verification、続いてRADAR Approvalという2段階を使う。Verificationは、取り込み後に人間がレビューすることを条件に、安全に先行して取り込めるかを判定する。Approvalは、Verification済みdiffをより厳しい基準で評価し、その事後レビューも完全に免除できるかを判定する。
両段階とも、静的なヒューリスティクス、DRS、RADAR Review Agentを組み合わせ、すべてのチェックの通過を要求する。作成者は常に制御権を持ち、RADAR Approvalで出荷する、人間のレビュアーを待つ、diffを「Needs Review」に戻す、といった選択ができる。
Verificationは3つのグループを順に処理する。
- メタデータと安全制約による適格性チェック:作業中・コメント募集ではなく、拒否済みでもコードフリーズ中でもなく、公開済みの最新バージョンであることを確認する。作成者は、管理職を含むSWE職群、データエンジニア、データサイエンティスト、または過去1年で10件を超えるdiffをコミットした人など、適格な条件を満たす必要がある。SWEインターンには60日以上の在籍期間を要求し、関連する運用上のオンコールローテーションも必要とする。オープンソース、SOX対象、追加レビューが必要なdiffは除外し、CIシグナルが許可された状態であることを確認する。
- 内容のチェック:禁止コード表現を含まず、接尾辞・接頭辞の拒否リストに合うファイルに触れないことを確認する。
- 意味解析とリスク評価:RADAR Review AgentがLLMによる意味解析を行い、DRSを設定可能なしきい値と比較する。既定値はP5で、最も低リスクな5%のみが対象となる。
すべてを通過すると、事後レビューを条件に、直ちに出荷可能であることが作成者に通知される。その後、Verification済みdiffは自動的にApprovalのより厳しい基準で評価される。合格すればRADAR Approvalを得て、事後レビューを含めて人間のレビューが不要になる。
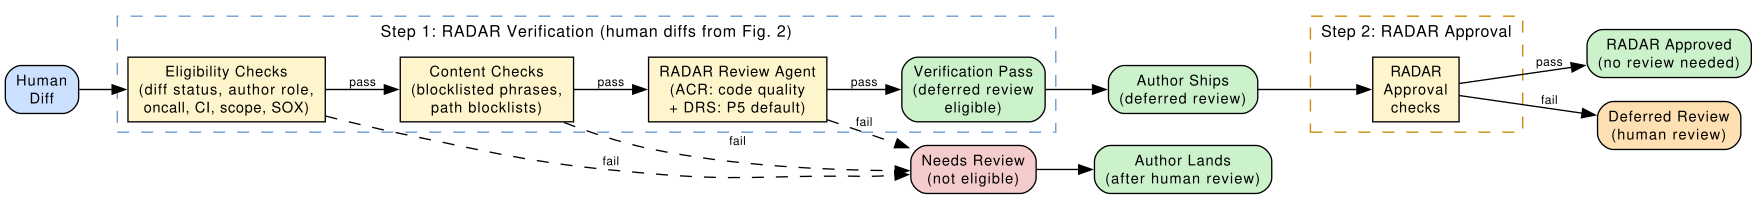
図4(原著から転載):人間作成diffのRADARパイプライン。第1段階のVerificationは、適格性、内容、RADAR Review AgentとDRS(既定P5)により、事後の人間レビューを条件に出荷可能かを評価する。第2段階のApprovalは、Verification済みdiffにより厳しい基準を適用し、合格したdiffでは人間のレビューを完全に不要にする。Verificationのどこかで失敗すれば、通常の人間レビューへ回る。
Verificationでは作成者の適格性、安全制約、diff状態のメタデータを確認し、内容のチェック、意味解析、DRS評価を行う。検証後、作成者は事後レビュー付きで出荷できる。続くApprovalが、より厳しい条件でその事後レビューも免除できるかを評価する。
本節は以降の背景と処理を説明した。次節以降では評価手法と結果指標を説明し、RADARへの介入について、目標指標と安全上のガードレール指標の両方を測る実験を報告する。
訳注:原著第2.9節末尾は「controlled experiments(対照を設けた実験)」と表現していますが、第3節と第6.3節は無作為割り付けを行わない観察的評価であると明記しています。研究設計の解釈では、そちらの具体的な記述に注意が必要です。
3. 研究設計
本論文は、適格性チェック、静的なヒューリスティクス、DRS、LLMによる自動レビュー、決定論的な検証を組み合わせる一貫したファネルであるRADARを評価する。拡大に伴うRADARの動作を明らかにし、効率面の結果との観察された関連を定量化すると同時に、導入中に監視した安全性の結果を報告することが目的である。
根拠とするのは、本番導入、導入規模での記述的な運用計測、時間をまたぐ観察的な比較、大規模データに対する差の差型の比較である。評価は3つの研究課題で構成する。各課題は本節の指標定義に従って分析し、期間は週・月単位で報告する。
RQ1(実現可能性):大規模な自動処理。 リスク別の自動化は、本番規模で、多様な組織のレビュー件数の相当部分を処理できるか。diffを分析単位に、レビュー件数、取り込み件数、レビューのピーク日次処理量、対象組織数、差し戻し・PIなどの安全性の結果を記述的に報告する。
RQ2(調整):リスクしきい値の変更。 自動化の適格性を決めるしきい値は、自動化できる割合と安全性のトレードオフをどう変えるか。DRSしきい値をp25からp50へ緩和した本番ポリシー変更を評価する。diffを分析単位とする、時間をまたぐ観察的比較である。RADAR承認率で自動化の割合を、Verification通過率で決定論的な検証の結果を測り、同期間に監視したPIと差し戻しも報告する。
RQ3(効果):AI生成diffのレビュー効率。 自動レビューは、AI生成変更のレビュー全体にかかる時間をどの程度短縮するか。diffを単位とする大規模な差の差型の比較により、RADARの対象拡大に伴うクローズまでの時間とレビュー実経過時間の変化を推定する。無作為割り付けではなく、モデルの完全な仕様も提示していないため、測定された差は観察的な推定値として報告する。
指標。 各課題について、処理量・対象範囲、自動化の割合・検証、効率、安全性の指標を報告する。表2に研究設計と報告範囲を、表3に使用する指標を示す。
表2:RADAR評価の研究設計。 記述的な運用計測、時間をまたぐ観察的比較、大規模データの差の差型の比較を用いる。
| 課題 | 内容 | 方法 | 分析単位 | 期間・規模 |
|---|---|---|---|---|
| RQ1 | 導入時の処理量と対象範囲 | 記述的な運用計測 | diff | 53万5,000件超をレビュー、33万1,000件超を取り込み |
| RQ2 | p25からp50へのポリシー変更 | 時間をまたぐ観察的比較 | diff | p25からp50への変更、53万5,000件超をレビュー |
| RQ3 | AI生成diffの効率 | 大規模データの差の差型の比較 | diff | RADARがレビューした53万5,000件超 |
表3:研究課題ごとの評価指標。 「—」はその課題では使用しないことを表す。
| 指標 | 説明 | RQ1 | RQ2 | RQ3 |
|---|---|---|---|---|
| RADARレビュー件数 | RADARが処理したdiff数 | 使用 | — | — |
| RADAR取り込み件数 | RADARが取り込んだdiff数 | 使用 | — | — |
| 日次処理量 | RADARレビュー件数の1日あたりピーク | 使用 | — | — |
| 対象範囲 | 対象組織数 | 使用 | — | — |
| RADAR承認率 | 適格なdiffのうちRADAR承認された割合 | — | 使用 | — |
| Verification通過率 | RADAR Verificationを通過したdiffの割合 | — | 使用 | — |
| クローズまでの時間 | diffの公開からクローズまでの時間の中央値 | — | — | 使用 |
| レビュー実経過時間 | レビュー待ちとレビュー中に費やす実時間の中央値 | — | — | 使用 |
| 差し戻し | 取り込んだdiffのうち差し戻された件数 | 使用 | 使用 | — |
| PI | 取り込んだdiffに起因する安全上のインシデント件数 | 使用 | 使用 | — |
4. 結果
4.1. RQ1:大規模な自動処理の実現可能性
リスク別の自動化は、本番規模で、多様な組織のレビュー件数の相当部分を処理できるか。
表4:RQ1に関するRADARの記述的な運用結果。
| 指標 | 報告値 |
|---|---|
| RADARがレビューしたdiff | 535,290件 |
| RADARが取り込んだdiff | 331,720件 |
| RADARレビュー対象diffの差し戻し率 | 非RADAR変更の3分の1(Fisherの正確確率検定、原文のp値表記:p-val < 1e^{16}) |
| RADARレビュー対象diffのPI率 | 非RADAR変更の50分の1(Fisherの正確確率検定、原文のp値表記:p-val < 1e^{6}) |
原著の脚注では、すべてのPIを分野の専門家が手動でレビューし、人間のレビュアーなら検出できたと判断されたものはなかった、としている。
訳注:p値表記 — 原文HTMLの数式には、指数の負号がなく、上表のとおり記載されています。
1e-16や1e-6を意図したものかは確認できないため、補正せず原表記を示しています。この表記から統計的有意性を判断することは避けます。
RADARは、人間の注意によって制約されるレビュー能力と、加速するコード作成との間のボトルネックに対処するために設計された。過去1年間で、人間が取り込んだdiffあたりの実質的なコード行数は105.9%増加し、開発者あたりの月間diff数は51%増加した。増加の80%超はエージェント型AIの支援による。レビューキューの増大が、高リスク変更へ人間の注意を向け、適格な低リスクdiffを自動化する動機となった。
表4のとおり、RADARは53万5,000件超をレビューし、33万1,000件超を取り込む規模に達した。日次レビュー処理量は2万5,000件に達し、差し戻し率は非RADAR変更の3分の1、PI率は50分の1だった。
これらの規模と安全性の結果は、適格性チェック、DRS、LLMレビュー、決定論的な検証を組み合わせたファネルが、良好な安全性の結果を維持しつつ、レビュー滞留の問題に意味のある量を処理できることを示す。重要な示唆は、人間のレビュアー能力を同じ割合で増やすことなく、定型的なdiffの一部を自動化で吸収できるという点である。24時間以内にレビューされるdiffの割合が低下している状況では、対象を低〜中程度の複雑さに限っても、この規模の処理量改善には意味がある。
RADARは数千件のdiffをレビュー・取り込みし、日次レビュー件数は2万5,000件に達した。差し戻し率は非RADAR変更の3分の1、PI率は50分の1だった。
4.2. RQ2:リスクしきい値の調整
自動化の適格性を決めるリスクしきい値の変更は、自動化できる割合と安全性のトレードオフにどう影響するか。
表5:p25からp50へのDRSしきい値緩和に関連する観察的な結果。 集計値を報告し、統計検定は報告しない。
| 指標 | 報告値 |
|---|---|
| DRSしきい値の変更 | p25からp50 |
| RADAR承認率(L7、現在) | 60.31% |
| RADAR Verification通過率(L7、現在) | 26.31% |
| 53万5,000件超のRADARレビュー対象における差し戻し率 | 非RADAR変更の3分の1 |
| 同PI率 | 非RADAR変更の50分の1 |
DRSは、より積極的な自動化の対象となるdiffを決める主要な仕組みである。厳しいしきい値はリスクを減らす一方、自動化できる割合を制限する。緩いしきい値は承認対象を広げ、処理量を増やし得る。調整の一環として、しきい値をp25からp50へ緩和した。
表5では、調整後の現在のRADAR承認率は60.31%(L7)、Verification通過率は26.31%(L7)となっている。これは、しきい値の調整が、より多くのdiffを先へ進め、検証段階の摩擦を減らすことで、ファネルの効率を改善したことを示す。
自動レビュー・取り込みのワークフローでは、安全性を明示的な制約として扱う。53万5,000件超のRADARレビュー対象の差し戻し率は非RADAR変更の3分の1、PI率は50分の1だった。これは因果的な推定ではないが、承認対象の拡大が大規模運用での安全性低下と関連していないことを示す重要な運用指標である。
p25からp50への緩和後、RADAR承認率は60.31%に達した。53万5,000件超の対象全体で、差し戻し率は非RADAR変更の3分の1、PI率は50分の1だった。
訳注:表の「現在」は論文執筆時点を指します。L7の期間定義や、変更前の承認率・通過率の具体値は、本文では明確に説明されていません。60.31%を「Metaのすべてのコード変更のうち自動承認された割合」と読み替えたり、535,290件に掛けて承認件数を算出したりすることはできません。
4.3. RQ3:レビュー効率への効果
自動レビューは、AI生成変更のレビュー全体にかかる時間をどの程度短縮するか。
表6:RADARが処理したdiffで観察された効率面の結果。
| 指標 | 報告値 |
|---|---|
| クローズまでの時間の中央値(RADAR対人間レビュー) | 原文表記「330%超の短縮」 |
| レビュー実経過時間の中央値(同) | 35%短縮 |
| 分析規模 | RADARがレビューした53万5,000件超のdiff |
RADARは、適格なdiff、とくにbotやAIプロンプトが生成したdiffについて、レビュー待ちの時間とレビュー負荷を減らすことを目的とする。diff数・規模の前年比の増加と、24時間以内にレビューされる割合の低下を考えると、これは重要である。
表6に観察された効率面の結果を示す。数十万件のRADARレビュー対象を通じて、人間がレビューしたdiffに比べ、クローズまでの時間の中央値は原文の表現で「330%超低く」、レビュー実経過時間の中央値は35%低かった。
これは、自動化がレビューキューでの待ち時間を大きく減らしたことを示し、適格な変更では、RADARが希少な人間のレビュー能力への依存を取り除くという説明と整合する。コード作成が急増する状況では、レビュー実経過時間の短縮により、低リスクdiffが高リスクdiffと人間の注意を奪い合うことを防げる。
53万5,000件超のRADARレビュー対象に基づくと、人間レビューと比べて、クローズまでの時間の中央値は原文表記で330%超、レビュー実経過時間の中央値は35%短縮された。
訳注:330%超の短縮とは何か — 要旨、表6、本文はいずれも同じ表現ですが、通常の短縮率
(変更前 − 変更後) / 変更前は、時間が非負なら100%を超えません。原著には、この数字を再計算するための比較元・比較先の時間が示されていません。「3.3倍速い」「約70%短縮」などへの換算は行わず、原文の未解決な表記として残します。
5. 関連研究と考察
本節では、関連研究における本研究の位置付けと、その重要性を論じる。
5.1. 現代のコードレビュー
コードレビューは、形式的なソフトウェアインスペクションから、ツールに支えられた軽量で非同期なワークフローへ進化した(Rigby et al., 2012; Rigby and Bird, 2013; Bacchelli and Bird, 2013)。実証研究は、不具合発見やプロセス順守を支えることを示している(McIntosh et al., 2016; Kononenko et al., 2015; Bosu et al., 2015)。GoogleとMetaの事例研究も、大規模環境でこれらの利点を確認している(Sadowski et al., 2018; Shan et al., 2022)。
一方、レビューの品質と参加は、レビュアーの負荷、経験、組織的な要因の影響を受ける(Bosu and Carver, 2013; Kononenko et al., 2015)。人間の注意と実時間による制約は、依然として課題である。ShanらはMetaでナッジを用いてレビューを加速した(Shan et al., 2022)。レビュアー推薦システムは、待ち時間の短縮と品質向上のために、変更を適切な人へ振り分ける(Asthana et al., 2019; Balachandran, 2013; Çetin et al., 2021; Rigby et al., 2025)。
RADARはこれらを補完する。人間によるレビュー自体の効率を改善するのではなく、自動検証で安全に代替できるdiffを特定し、限られた人間の注意を高リスクの変更へ向ける。
5.2. リスクを考慮した開発と欠陥予測
ソフトウェア変更のリスク予測には長い歴史がある。初期の研究では、変更履歴の特徴から故障しやすいモジュールを予測できることが示された(Graves et al., 2000; Mockus and Weiss, 2000)。後の研究は、これをコミット単位のJust-in-Time欠陥予測へ拡張した(Kamei et al., 2016)。産業界では、ファイル単位のリスクスコアが、リファクタリングの優先順位付けや品質改善活動の重点化に使われている(Mockus et al., 2025)。
RADARは、リスク予測をレビューのワークフローへ直接適用するMetaのDRSを基盤とする。DRSは、承認から出荷までの処理、コードフリーズ管理、リスクに応じたレビュアー推薦など、Metaの約20の機能を支える(Rigby et al., 2025)。RADARでは、自動レビューと取り込みの対象を決めるゲートとなり、組織が許容リスクを調整できるしきい値を持つ。
これは、危険なdiffをレビュアーに知らせるという「情報」のためのリスクモデルから、低リスクdiffのレビュー判断を自動化するという「行動」のためのモデルへの移行である。
5.3. AIによるコーディング支援とコーディングエージェント
コード生成向けの大規模言語モデルは、開発のワークフローを変えた。コード補完ツールが広く普及し(Chen et al., 2021; Peng et al., 2023)、最近では、自律的にコード作成、テスト、リファクタリングを行うLLMエージェントが登場した(Wang et al., 2025; Liu et al., 2024; Yang et al., 2024)。Liらはこれを、自律的なコーディングエージェントが大規模にコードを作成・レビュー・発展させる「SE 3.0」と捉える(Li et al., 2025)。
Metaでは、リファクタリング、不要コード削除、複雑度低減などのコード改善活動がdiffの14%超を占める(Mockus et al., 2025)。RACERは、事前定義されたランブックからdiffを生成し、これらの多くを自動化する(Shackleton et al., 2023)。
AI生成コードの急増は、レビュー能力へ直接的な圧力をかける。RADARは、その下流の問題に対処する。AIエージェントがより多くのdiffを作るなら、レビューパイプラインも対応して拡大する必要がある。ACEはRACERやCodemodServiceなどのbot diffを扱うために設計されており、低リスクの自動変更は人間のレビューなしで取り込み、高リスク変更は人間へ回す。
5.4. 自動コードレビュー
静的解析ツールは、人間が確認する前に、バグ、スタイル違反、セキュリティ問題を見つけるため、長くレビューのワークフローに組み込まれてきた(Balachandran, 2013; Sadowski et al., 2018)。最近は、レビューそのものの一部をLLMで自動化する試みが進んでいる。産業界では、レビューコメント生成、品質問題の検出、変更のリスク分類などが検討されている。
RADARのACRは、LLMを使ってdiff内の変更を安全・リスクのカテゴリに分類し、自動パイプラインの承認・拒否を決める。作成者やレビュアーへの助言を目的とする一般的なLLMレビューツールと異なり、「人間のレビューなしで取り込めるほど安全か」という二者択一の判断を目的とする。
この設計は、自動化の範囲と安全性のトレードオフにおける特定の運用点を表す。承認には、すべての変更で高い信頼度、少なくとも10点中8点を要求する。
5.5. 考察
研究課題に沿って知見を整理する。
実現可能性(RQ1):RADARは、リスクを考慮したレビューと取り込みの自動化を、処理全体を覆う本番ワークフローとして大規模に実現できることを示した。53万5,000件超をレビューし、33万1,000件超を取り込み、1日2万5,000件に達した。差し戻し率は非RADAR変更の3分の1、PI率は50分の1である。
従来のリスクに応じたレビュー研究は、リスク情報の提示(Rigby et al., 2025)や、危険なdiffに適切なレビュアーを推薦すること(Asthana et al., 2019)に焦点を当てていた。RADARは逆に、リスクスコアで人間のレビューが不要なdiffを特定し、低リスク変更のレビューから取り込みまでを自動化する。
その重要な要素が、生成元ごとに異なる適格性モデルである。決定論的codemodではdiffごとのAIレビューを省略し、AI生成codemodではACEを個別に実施し、RACERランブックでは履歴、日次上限、DRSしきい値をランブック単位で管理する。
これにより、パイプライン全体よりも細かな単位で、処理量と安全性のトレードオフを調整できる。この大規模な運用実績は、AIコーディング支援のベンチマーク中心の評価(Yang et al., 2024; Li et al., 2025)を補完し、大きなモノレポでのリスクに応じた自動化に関する実証的理解を広げる。
調整(RQ2):リスク調整は、運用上の実用的な操作手段となる。承認対象をp25からp50へ広げたことは、自動化できる割合の増加と後段の検証の改善に関連し、安全性の結果は安定していた。これは、運用上の確信が高まるにつれて、初期の保守的なしきい値を段階的に緩和できる可能性を示す。また、しきい値と安全性の関係は線形ではなく、範囲の拡大によって、インシデント率を比例的に増やさずに追加の低リスクdiffを取り込める可能性がある。
効果(RQ3):クローズまでの時間とレビュー実経過時間の短縮は、レビューキューへの圧力を和らげ、人間の注意を高リスクdiffへ向ける助けとなる。観察された短縮、すなわちクローズまでの時間の中央値で原文表記330%超、レビュー実経過時間の中央値で35%という値は、自動化が元から速いdiffをさらに加速しただけではなく、実際のボトルネックを取り除いていることを示唆する。
知識伝達:レビューの自動化に伴う知識伝達を分析することで、自動化研究では十分に扱われてこなかった、レビュー効率とレビューを通じた知識の共有のトレードオフを取り上げる(Rigby et al., 2014)。私たちのネットワーク分析では、RADARの対象diffは典型的な人間レビュー対象とは質的に異なるため、現在は好ましいバランスにある。ただし、自動化の範囲が広がれば、このバランスは変わる可能性がある。
訳注:知識伝達の段落は原著の記述を訳したものです。この版の本文では、言及されているネットワーク分析の具体的な手順や数値結果は提示されていません。
6. 妥当性への脅威
6.1. 一般化可能性
本研究は、MetaのRADARおよび周辺のレビュー・デプロイ基盤を用いて行われた。組織の状況には、大きなモノレポ、標準化されたツール、テストと段階的な展開の高い自動化率が含まれる。他の組織では、リポジトリ構造、レビューの慣行、許容リスク、検証基盤が異なる場合がある。こうした違いは、同様のファネルの導入可能性と、処理量・効率の変化の大きさの双方に影響し得る。
結果は、RADARの適格性を満たす、複雑さが低〜中程度のdiffを対象とする。適格性ポリシー、DRS、LLMレビュー、決定論的な検証など、Meta固有のワークフローで評価した。対象を選ぶ基準は、他のコードベースや領域、とくに変更が大きい、テストの信頼性が低い、リリースが段階的でない環境には一致しない可能性がある。
さらに、プライバシーと機密保持の制約により、正確な日付とdiff単位の元データは公開できない。このことは直接的な追試を制限し得る。
6.2. 構成概念妥当性
いくつかの結果は代理指標である。クローズまでの時間とレビュー実経過時間は、応答性と待ち行列の影響を捉えるが、不具合の防止や長期的な保守性を直接測らない。処理量の指標は規模を示すが、置き換えたレビューの限界的な価値までは定量化しない。
安全性の結果も慎重な解釈を要する。PIと差し戻しの率は運用指標だが、すべての害を捉えるものではない。PIとして扱われずにリグレッションが修正される場合もあれば、予防的な差し戻しもある。複数の変更が近い時刻に取り込まれると、インシデントの原因帰属も完全ではない。
AI生成と人間作成の境界も脅威となる。人間作成diffでもAI支援が使われ得るため、カテゴリの区別が曖昧になるからである。
6.3. 内的妥当性
diffはRADARへ無作為に割り当てられていないため、観測できない交絡が変化に影響する可能性がある。段階的な展開、適格性ポリシーの進化、対象diffの複雑さやテスト範囲の構成変化が生じる。RQ2では、登録、モデルの動作、検証ルールの変更が、しきい値の変更と同時に起こる可能性がある。
RQ3の差の差推定は、平行トレンドの仮定と安定した計測に依存するが、モデルの完全な仕様は提示していない。システム全体での干渉もあり得る。RADARが低リスクの量を引き受けると、残りのdiffのキューの動きも変わり、測定された改善にこうした二次的な効果が含まれる可能性がある。
7. 結論
私たちは、適格な低〜中程度の複雑さのdiffについてレビューと取り込みを自動化し、高リスクの変更を人間へ回す、一貫したワークフローであるRADARを示した。実現可能性、調整、効果に沿った評価から、リスク別の自動化が本番規模で機能することを示した。RADARは数十万件のdiffをレビュー・取り込みし、差し戻し率は非RADAR変更の3分の1、PI率は50分の1だった。
リスクしきい値をp25からp50へ緩和することで、安全性を損なうことなく自動化できる割合が増えた。人間レビューに比べ、RADARはクローズまでの時間の中央値を原文表記で330%超、レビュー実経過時間の中央値を35%短縮する。
これらの知見は、ポリシー上のゲート、リスクスコア、LLMレビュー、決定論的な検証を組み合わせた多層的自動化が、AIによるコード増加で生じる定型的なレビュー量を吸収できることを示唆する。また、リスクしきい値が実用的な調整手段となり、待ち時間の短縮が、人間の判断が最も役立つ変更へ注意を向ける助けになる。
今後は、レビュー滞留や見逃された不具合率への長期的影響と、対象範囲の拡大に応じ、コード領域・変更種類ごとに適格性ポリシーをどう調整できるかを研究する必要がある。
参考文献(原著の書誌情報)
以下は原著の参考文献です。本文中の著者名・年による参照と対応するよう、書誌情報を原語で掲載します。
Asthana et al . (2019) Sumit Asthana, Rahul Kumar, Ranjita Bhagwan, Christian Bird, Chetan Bansal, Chandra Maddila, Sonu Mehta, and B Ashok. 2019. WhoDo: automating reviewer suggestions at scale. In Joint European Software Engineering Conference and Symposium on the Foundations of Software Engineering . 937–945.
Bacchelli and Bird (2013) Alberto Bacchelli and Christian Bird. 2013. Expectations, outcomes, and challenges of modern code review. In International Conference on Software Engineering . 712–721.
Balachandran (2013) Vipin Balachandran. 2013. Reducing human effort and improving quality in peer code reviews using automatic static analysis and reviewer recommendation. In International Conference on Software Engineering . 931–940.
Bosu and Carver (2013) Amiangshu Bosu and Jeffrey C Carver. 2013. Impact of peer code review on peer impression formation: A survey. In International Symposium on Empirical Software Engineering and Measurement . 133–142.
Bosu et al . (2015) Amiangshu Bosu, Michaela Greiler, and Christian Bird. 2015. Characteristics of useful code reviews: An empirical study at microsoft. In International Working Conference on Mining Software Repositories . 146–156.
Çetin et al . (2021) H Alperen Çetin, Emre Doğan, and Eray Tüzün. 2021. A review of code reviewer recommendation studies: Challenges and future directions. Science of Computer Programming (2021), 102652.
Chen et al . (2021) Mark Chen, Jerry Tworek, Heewoo Jun, Qiming Yuan, Henrique Ponde de Oliveira Pinto, Jared Kaplan, Harri Edwards, Yuri Burda, Nicholas Joseph, Greg Brockman, Alex Ray, Raul Puri, Gretchen Krueger, Michael Petrov, Heidy Khlaaf, Girish Sastry, Pamela Mishkin, Brooke Chan, Scott Gray, Nick Ryder, Mikhail Pavlov, Alethea Power, Lukasz Kaiser, Mohammad Bavarian, Clemens Winter, Philippe Tillet, Felipe Petroski Such, Dave Cummings, Matthias Plappert, Fotios Chantzis, Elizabeth Barnes, Ariel Herbert-Voss, William Hebgen Guss, Alex Nichol, Alex Paino, Nikolas Tezak, Jie Tang, Igor Babuschkin, Suchir Balaji, Shantanu Jain, William Saunders, Christopher Hesse, Andrew N. Carr, Jan Leike, Josh Achiam, Vedant Misra, Evan Morikawa, Alec Radford, Matthew Knight, Miles Brundage, Mira Murati, Katie Mayer, Peter Welinder, Bob McGrew, Dario Amodei, Sam McCandlish, Ilya Sutskever, and Wojciech Zaremba. 2021. Evaluating Large Language Models Trained on Code. arXiv:2107.03374 [cs.LG]
Graves et al . (2000) T. L. Graves, A. F. Karr, J. S. Marron, and H. Siy. 2000. Predicting fault incidence using software change history. IEEE Transactions on Software Engineering 26, 2 (2000).
Kamei et al . (2016) Yasutaka Kamei, Takafumi Fukushima, Shane McIntosh, Kazuhiro Yamashita, Naoyasu Ubayashi, and Ahmed E Hassan. 2016. Studying just-in-time defect prediction using cross-project models. Empirical Software Engineering 21, 5 (2016), 2072–2106.
Kononenko et al . (2015) Oleksii Kononenko, Olga Baysal, Latifa Guerrouj, Yaxin Cao, and Michael W Godfrey. 2015. Investigating code review quality: Do people and participation matter?. In IEEE international conference on software maintenance and evolution (ICSME) . 111–120.
Li et al . (2025) Hao Li, Haoxiang Zhang, and Ahmed E. Hassan. 2025. The Rise of AI Teammates in Software Engineering (SE) 3.0: How Autonomous Coding Agents Are Reshaping Software Engineering. arXiv:2507.15003 [cs.SE]
Liu et al . (2024) Junwei Liu, Kaixin Wang, Yixuan Chen, Xin Peng, Zhenpeng Chen, Lingming Zhang, and Yiling Lou. 2024. Large Language Model-Based Agents for Software Engineering: A Survey. arXiv:2409.02977 [cs.SE]
McIntosh et al . (2016) Shane McIntosh, Yasutaka Kamei, Bram Adams, and Ahmed E. Hassan. 2016. An Empirical Study of the Impact of Modern Code Review Practices on Software Quality. Empirical Software Engineering 21, 5 (2016), 2146–2189.
Mockus et al . (2025) Audris Mockus, Peter C Rigby, Rui Abreu, Anatoly Akkerman, Yogesh Bhootada, Payal Bhuptani, Gurnit Ghardhora, Lan Hoang Dao, Chris Hawley, Renzhi He, Sagar Krishnamoorthy, Sergei Krauze, Jianmin Li, Anton Lunov, Dragos Martac, Francois Morin, Neil Mitchell, Venus Montes, Maher Saba, Matt Steiner, Andrea Valori, Shanchao Wang, and Nachiappan Nagappan. 2025. Metrics Driven Reengineering and Continuous Code Improvement at Meta. In International Conference on Automated Software Engineering .
Mockus and Weiss (2000) Audris Mockus and David M. Weiss. 2000. Predicting Risk of Software Changes. Bell Labs Technical Journal 5, 2 (April–June 2000), 169–180.
Peng et al . (2023) Sida Peng, Eirini Kalliamvakou, Peter Cihon, and Mert Demirer. 2023. The Impact of AI on Developer Productivity: Evidence from GitHub Copilot. In Arxiv . https://arxiv.org/abs/2302.06590
Rigby et al . (2012) Peter Rigby, Brendan Cleary, Frederic Painchaud, Margaret-Anne Storey, and Daniel German. 2012. Contemporary peer review in action: Lessons from open source development. IEEE software 29 (2012), 56–61.
Rigby and Bird (2013) Peter C Rigby and Christian Bird. 2013. Convergent contemporary software peer review practices. In International Symposium on the Foundations of Software Engineering . 202–212.
Rigby et al . (2014) Peter C Rigby, Daniel M German, Laura Cowen, and Margaret-Anne Storey. 2014. Peer review on open-source software projects: Parameters, statistical models, and theory. ACM Transactions on Software Engineering and Methodology (TOSEM) 23, 4 (2014), 35.
Rigby et al . (2025) Peter C. Rigby, Seth Rogers, Sadruddin Saleem, Parth Suresh, Daniel Suskin, Patrick Riggs, Chandra Maddila, Nachiappan Nagappan, and Audris Mockus. 2025. Improving Code Reviewer Recommendation: Accuracy, Latency, Workload, and Bystanders. ACM Trans. Softw. Eng. Methodol. (May 2025). https://doi.org/10.1145/3736405
Sadowski et al . (2018) Caitlin Sadowski, Emma Söderberg, Luke Church, Michal Sipko, and Alberto Bacchelli. 2018. Modern code review: a case study at google. In Proceedings of the 40th International Conference on Software Engineering: Software Engineering in Practice . ACM, 181–190.
Shackleton et al . (2023) Will Shackleton, Katriel Cohn-Gordon, Peter C Rigby, Rui Abreu, James Gill, Nachiappan Nagappan, Karim Nakad, Ioannis Papagiannis, Luke Petre, Giorgi Megreli, et al . 2023. Dead Code Removal at Meta: Automatically Deleting Millions of Lines of Code and Petabytes of Deprecated Data. In Proceedings of the 31st ACM Joint European Software Engineering Conference and Symposium on the Foundations of Software Engineering . 1705–1715.
Shan et al . (2022) Qianhua Shan, David Sukhdeo, Qianying Huang, Seth Rogers, Lawrence Chen, Elise Paradis, Peter C. Rigby, and Nachiappan Nagappan. 2022. Using nudges to accelerate code reviews at scale. In Proceedings of the 30th ACM Joint European Software Engineering Conference and Symposium on the Foundations of Software Engineering (ESEC/FSE 2022) . Association for Computing Machinery, 472–482. https://doi.org/10.1145/3540250.3549104
Wang et al . (2025) Yanlin Wang, Wanjun Zhong, Yanxian Huang, Ensheng Shi, Min Yang, Jiachi Chen, Hui Li, Yuchi Ma, Qianxiang Wang, and Zibin Zheng. 2025. Agents in software engineering: Survey, landscape, and vision. Automated Software Engineering 32, 2 (2025), 1–36.
Yang et al . (2024) John Yang, Carlos E. Jimenez, Alexander Wettig, Kilian Lieret, Shunyu Yao, Karthik Narasimhan, and Ofir Press. 2024. SWE-agent: Agent-Computer Interfaces Enable Automated Software Engineering. In Advances in Neural Information Processing Systems , Vol. 37. Curran Associates, Inc., 50528–50652.